
De catálogo pasivo a grafo de conocimiento activo
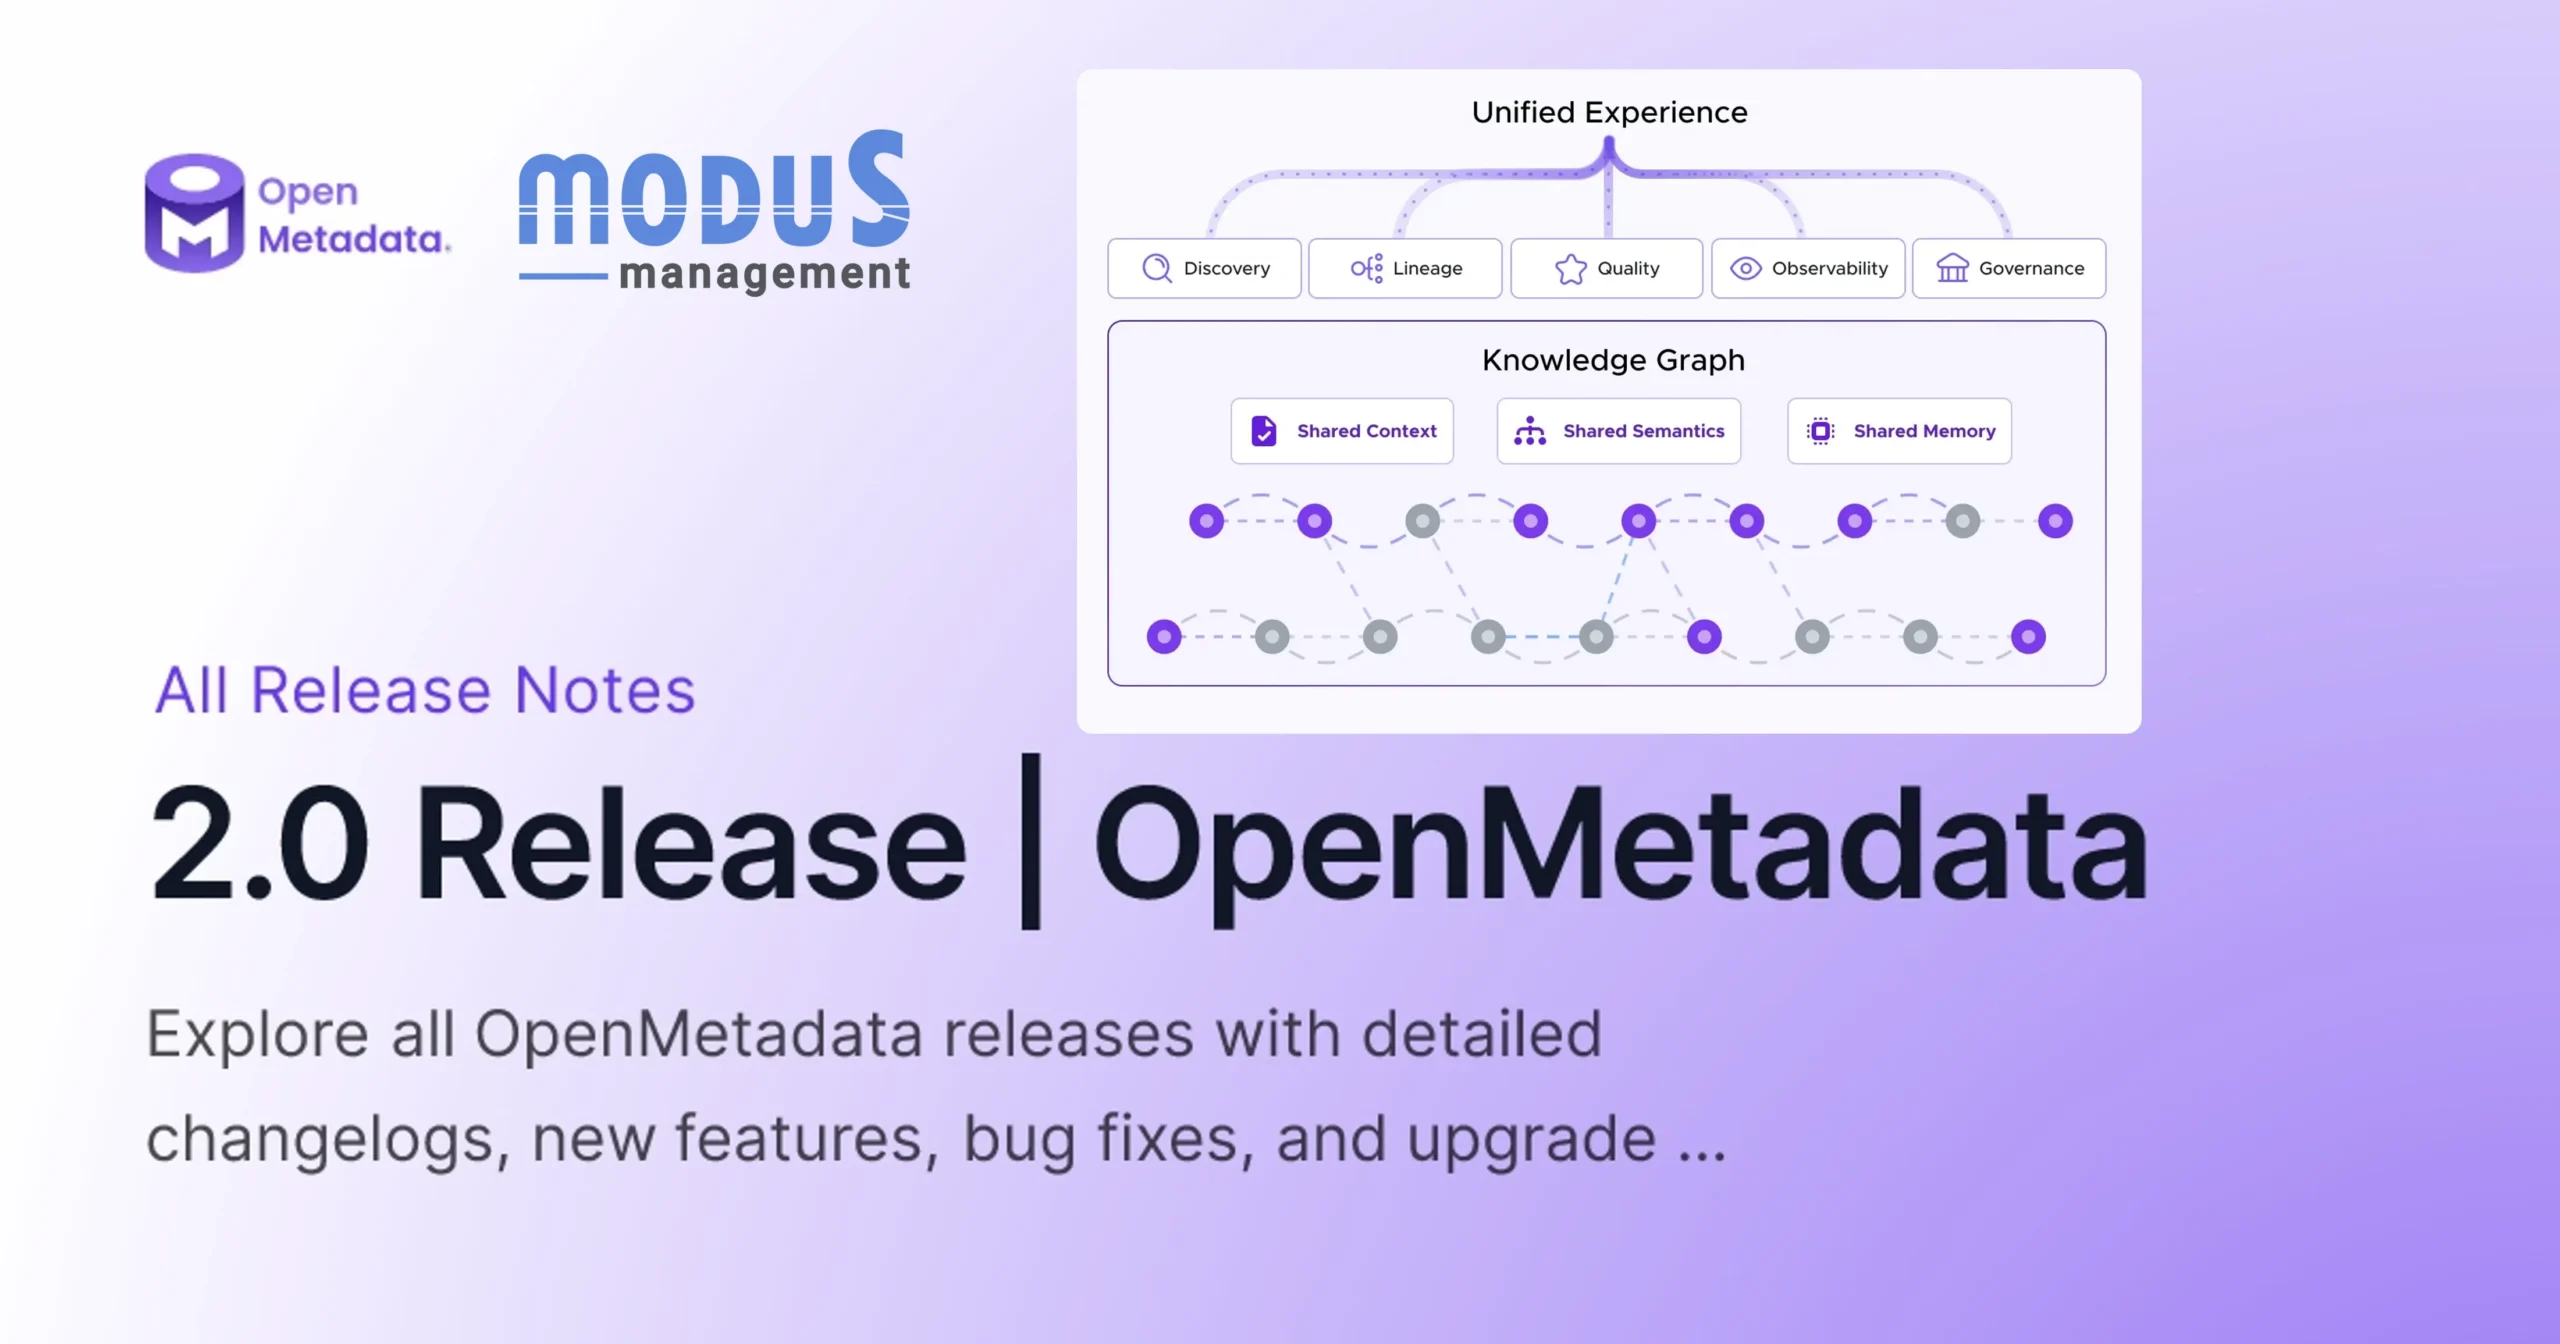
La historia de OpenMetadata ayuda a entender hacia dónde va el proyecto. La versión 1.0 nació como un motor de catálogo centrado en dominios, productos de datos y linaje básico. Con el tiempo fue creciendo hasta convertirse en una plataforma de gobernanza a escala empresarial. La versión 2.0 da un paso más allá y organiza toda esa base alrededor de tres conceptos que el propio equipo del proyecto define como los pilares del nuevo modelo:
– Contexto: qué datos existen. Conecta metadatos, documentos, políticas, linaje, señales de calidad y reglas de acceso relevantes para una tarea concreta.
– Ontología: qué significan esos datos, a través de los conceptos de negocio y las relaciones tipadas que permiten a un agente interpretar correctamente ese contexto.
– Memoria: qué decisiones y correcciones se han aprobado ya, de forma que la siguiente respuesta parta de lo que la organización ya ha resuelto, en lugar de reinventar la rueda cada vez.
Estos tres primitivos se construyen sobre un grafo de conocimiento basado en estándares abiertos como OWL y RDF, lo que garantiza que ese contexto sea portable: no queda atrapado en un formato propietario, sino que puede ser consumido tanto por agentes de Collate (la capa comercial construida sobre OpenMetadata) como por cualquier aplicación de IA externa que hable el mismo lenguaje semántico.
En la práctica, esto significa que OpenMetadata 2.0 ya no solo responde a «¿dónde está la tabla `orders`?», sino a preguntas de negocio como «¿qué regiones no cumplieron el plan de ingresos del trimestre?», devolviendo una respuesta que un agente de IA puede justificar con la definición de negocio, el linaje y las políticas correctas detrás del dato.
Ingesta y conexión: rediseñadas para ser prácticamente invisibles
Uno de los objetivos declarados del equipo de ingesta en esta versión es simple de enunciar y difícil de conseguir: que conectar y mantener fuentes de datos deje de ser una fuente de fricción diaria para los ingenieros. La nueva experiencia de conexión e ingesta, que da servicio a más de 130 fuentes de datos (almacenes, bases de datos, herramientas de BI, catálogos y pipelines, incluyendo Snowflake, Databricks o Tableau), incorpora varias mejoras muy tangibles:
– Formularios de conexión dinámicos
Los formularios de configuración de conectores como MySQL o Snowflake se han reorganizado en secciones lógicas (General, Autenticación, Opciones adicionales, Configuración avanzada) e incluyen documentación interactiva lateral que acompaña al usuario paso a paso sin obligarle a salir de la interfaz.
– Diagnóstico inteligente de conexión
Antes, un fallo de conexión devolvía una traza críptica del driver de turno. Ahora, un motor de autodiagnóstico traduce el error a lenguaje humano: «conexión rechazada, revisa host y puerto» o «fallo de autenticación, comprueba usuario, contraseña o permisos». Un detalle pequeño que ahorra horas de soporte cuando gestionas decenas de conectores.
– Filtros sin expresiones regulares
Configurar exclusiones de tablas o esquemas solía obligar a dominar regex. OpenMetadata 2.0 introduce operadores legibles *empieza con*, *termina con*, *contiene*, *es exactamente* con traducción en tiempo real a la expresión regular equivalente, y una regla de precedencia clara: la exclusión siempre gana sobre la inclusión.
– Verificación de acceso previa y visibilidad de la ejecución
La ingesta reconstruida verifica los permisos de acceso antes de lanzar un job, identifica fallos de configuración de antemano y traslada el alcance a nivel de servicio (service-level scope) a los workflows de ingesta. Para entornos con cientos de miles de tablas, el Agents UI añade una barra de progreso con ETA y auto-pulling de logs en pantalla, sin necesidad de refrescar manualmente.
– Metadata agents especializados, orquestados por AutoPilot
Una vez conectada la fuente, metadata, linaje, uso, profiles, señales de calidad y clasificaciones pasan a formar parte de un knowledge graph compartido. Ahí entran en juego los specialized metadata agents: el *Profiler agent* analiza la forma y las características de los datos, el *Lineage agent* reconstruye automáticamente el linaje a partir de queries y flujos de datos, y el *Classification agent* analiza PII para etiquetarla. AutoPilot orquesta a los tres agentes across the data estate, de forma que la metadata queda lista para usarse sin que un ingeniero tenga que ejecutar cada paso manualmente.
El resultado: los equipos de datos dejan de perder horas depurando conexiones rotas y pueden centrarse en lo que de verdad aporta valor: gobernar y explotar la metadata.
Antes, un fallo de conexión devolvía una traza críptica del driver de turno. Ahora, un motor de autodiagnóstico traduce el error a lenguaje humano: «conexión rechazada, revisa host y puerto» o «fallo de autenticación, comprueba usuario, contraseña o permisos»
Context Center: el fin del conocimiento disperso
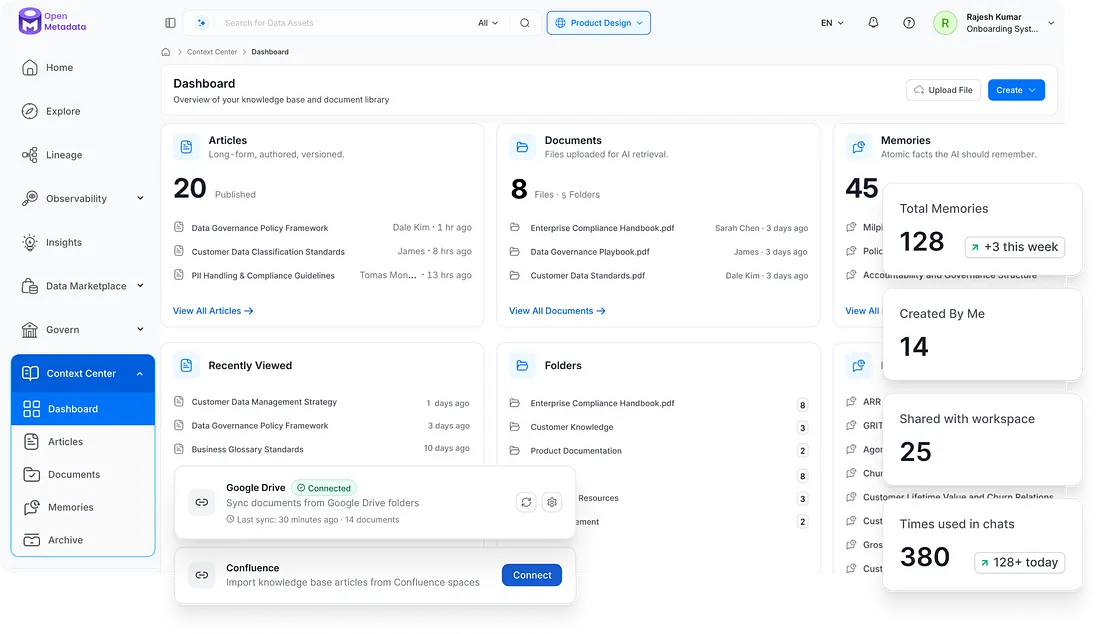
Buena parte del conocimiento crítico de una empresa guías de uso, políticas de gobernanza, runbooks de remediación, excepciones documentadas en un hilo de Slack vive fuera de la base de datos, repartido entre wikis, Notion, Confluence o Google Drive. OpenMetadata 2.0 absorbe el antiguo *Knowledge Center* y lo transforma en el Context Center, el destino unificado para todo ese contenido de referencia, estructurado en tres pilares:
– Artículos: contenido en formato largo, en Markdown, con soporte para adjuntos e imágenes, pensado para políticas de gobernanza o guías técnicas. Se vinculan de forma bidireccional a los activos: una guía de acceso a datos de clientes puede quedar adjunta a la tabla `dim_customer` y aparecer directamente en su pestaña de catálogo.
– Documentos: carga y organización de archivos y PDFs estructurados por departamento (Finanzas, Ingeniería, etc.). La plataforma no se limita a almacenarlos: extrae automáticamente las entidades relevantes del documento para enriquecer la búsqueda semántica. Los contenidos migrados de versiones anteriores se convierten automáticamente en Artículos, sin intervención manual.
– Memorias: hechos cortos y directrices rápidas, pensados para capturar los pequeños «nuggets» de conocimiento que surgen en conversaciones y correcciones diarias entre ingenieros y asistentes de IA. En lugar de que esa corrección quede enterrada en un hilo de chat, se almacena de forma gobernada e indexada, disponible para el resto de equipos y para otros agentes de IA.
Un matiz importante para cualquier responsable de seguridad: los controles de acceso configurados en la plataforma se aplican también cuando un agente de IA recupera este material. Si un usuario o un token no tiene permiso para ver un documento del Context Center desde la interfaz web, el agente conectado por MCP tampoco podrá consultarlo ni revelarlo. El contexto se enriquece, pero la gobernanza no se relaja.
Context Center también puede conectarse con fuentes de conocimiento de terceros, como Confluence o Google Drive, para incorporar políticas de negocio (reconocimiento de ingresos, cumplimiento GDPR, segmentación territorial) sin duplicar el trabajo de documentación que ya existe en la empresa.
Relaciones explícitas: Knowledge Graph y Ontology Explorer
Conectar el contexto técnico con el significado de negocio es, quizás, el reto más difícil de cualquier estrategia de datos. OpenMetadata 2.0 aborda esto con dos visualizaciones complementarias:
– El Knowledge Graph, centrado en el activo: partiendo de cualquier tabla, dashboard o pipeline, muestra todo lo que está conectado a ese activo definiciones de negocio, propietarios, políticas, linaje, calidad, productos de datos y activos de IA relacionados.
– El Ontology Explorer, que hace navegables las relaciones entre conceptos de negocio y las conecta con los activos de datos que los implementan. Así, un concepto como «Ingresos» queda vinculado directamente a las tablas físicas que lo sustentan.
Juntas, ambas vistas ofrecen las dos direcciones del mismo grafo: de los datos hacia el significado de negocio, y del significado de negocio hacia los datos que lo materializan. Para un agente de IA, esta doble dirección es lo que marca la diferencia entre «encontrar una tabla que se llama parecido» y «encontrar la tabla correcta y saber justificar por qué es la correcta».
Persona-Based Context Curation: menos ruido, más precisión y menos coste de tokens
Tener todo el contexto disponible no sirve de mucho si un analista de negocio recibe la misma avalancha de metadata técnica que un ingeniero de datos. Este es exactamente el problema que resuelve Persona-Based Context Curation, la función con la que OpenMetadata 2.0 sustituye al antiguo *AI Context Shield*: un administrador define qué assets y qué señales definitions, metrics, joins, lineage, quality, profiles, samples recibe cada rol (business user, data engineer, compliance lead…), filtrando por servicio, dominio, término de glosario, etiqueta o tipo de activo.
El resultado es que una persona de finanzas (humana o agente) recibe la métrica de ingresos aprobada y la planning policy correspondiente, mientras que un engineer que investiga el mismo resultado recibe los esquemas subyacentes, el lineage, los quality failures y los transformation models. Cada usuario recibe exactamente el contexto que necesita, sin clutter innecesario.
Esto no es solo una cuestión de comodidad: reducir el context bloat que llega a un modelo de lenguaje reduce drásticamente el consumo de tokens y mejora de forma medible la precisión (performance) de las respuestas de los agentes de IA. Es, probablemente, una de las palancas de ahorro más subestimadas de esta actualización.
Data Marketplace: autoservicio de datos con confianza incorporada
OpenMetadata 2.0 unifica Dominios y Productos de Datos en un verdadero Data Marketplace interno. Los equipos productores modelan su parcela de datos como dominios y publican productos de datos con puertos de entrada y salida, propietarios, definiciones, linaje y señales de calidad. Los equipos consumidores pueden buscar y filtrar por propietario, glosario, tipo de dominio, etiquetas o servicio, y evaluar un producto candidato antes de usarlo, comprobando sus definiciones, propiedad, linaje y calidad.
Los nuevos formularios de entrada personalizados (Custom Intake Forms) permiten forzar campos obligatorios y propiedades personalizadas sobre productos de datos, dominios y términos de glosario tanto a nivel de interfaz como de API, garantizando que cualquier producto publicado cumple con lo que exige la política de gobernanza de la empresa, y no solo con la buena voluntad de quien lo sube.
Los equipos productores modelan su parcela de datos como dominios y publican productos de datos con puertos de entrada y salida, propietarios, definiciones, linaje y señales de calidad
Búsqueda avanzada y ajuste fino de relevancia (Steering)
En organizaciones grandes, la duplicación de tablas es crónica: decenas de tablas llamadas «orders» o «customers», creadas por equipos distintos con propósitos distintos. OpenMetadata 2.0 pone en manos de los administradores herramientas muy concretas para decidir qué aparece primero:
– Ajuste fino de ranking (Search Settings): prioriza tablas según su nivel de uso o certificación (Tier 1, Gold), de forma que las fuentes de confianza aparezcan primero tanto para usuarios humanos como para agentes autónomos.
– Parámetros de relevancia: controles deslizantes para ajustar el peso de las coincidencias exactas de nombre, las frases conceptuales o las búsquedas por prefijo muy útil para quien abrevia «cd» en lugar de «customer».
– Búsqueda e indexación a nivel de columna: las columnas se indexan como entidades independientes, lo que permite rastrear propiedades personalizadas, propietarios y linaje a nivel de campo individual, no solo de tabla.
– Soporte vectorial en Elasticsearch: la búsqueda semántica y la generación de embeddings, antes reservadas a instalaciones sobre OpenSearch, ahora funcionan también de forma nativa sobre Elasticsearch, sin trabajo adicional al actualizar.
Gestión operativa de métricas y Explore rediseñado
La gestión de métricas de negocio también recibe un rediseño notable:
– Importación y exportación inteligente de CSV, con un editor interactivo que valida los datos antes de importarlos y muestra en una vista previa si una fila va a actualizar una métrica existente, añadir una columna o crear un registro nuevo.
– Edición masiva (Bulk Edit) sobre métricas y glosarios completos, directamente desde la interfaz, en formato de cuadrícula.
– Exportación de activos filtrados desde el explorador (Explore 2.0): ahora se pueden aplicar filtros complejos, centrar la vista en esquemas concretos y exportar el listado resultante a un archivo para uso externo.
Además, la página de inicio se ha rediseñado con una navegación más limpia y accesos más directos a descubrimiento de activos, linaje, gobernanza y calidad de datos, reduciendo el número de clics necesarios para llegar a cada función.
Context API y MCP 2.0: contexto listo para agentes, en una sola llamada
Aquí está, probablemente, el cambio más relevante para cualquier equipo que ya esté construyendo agentes de IA sobre sus datos. La Context API y las herramientas de Model Context Protocol (MCP) se han rediseñado para entregar contexto de forma mucho más rápida y compacta:
– La llamada `get_asset_context` devuelve, en una sola petición, todo el contexto relacionado con un activo: esquema, lógica de transformación, definiciones de negocio, clasificaciones, linaje, calidad, propietarios y conocimiento relevante del Context Center.
– La llamada equivalente a nivel de persona, `get_persona_context`, aplica automáticamente el filtrado por rol descrito antes.
– El contenido se extrae de documentos más largos mediante *chunking* semántico, y el servidor MCP embebido lo expone bajo las mismas políticas de control de acceso basadas en roles (RBAC) y atributos (ABAC) que ya existen en la plataforma.
– Esta información está disponible tanto en Markdown compacto (pensado para un modelo de lenguaje) como en JSON estructurado (pensado para una aplicación).
La gobernanza aquí es de extremo a extremo: los permisos que configuras en la interfaz web se heredan sin fisuras en las llamadas a la API y en el servidor MCP. Si un usuario o un token no tiene acceso a un dato o documento, el agente de IA conectado a través de MCP tampoco podrá acceder a él. Es, en la práctica, la respuesta de OpenMetadata a uno de los mayores frenos de la adopción de IA empresarial: dar acceso a los agentes sin perder el control de quién ve qué.
Todo esto se apoya en soporte nativo para estándares abiertos como DCAT, DPROD, RDF, SKOS, PROV-O, OWL, Schema.org, ODCS, OSI y OpenLineage, además del propio MCP. Es una apuesta explícita por evitar el bloqueo de proveedor (*vendor lock-in*): tu contexto se mantiene abierto, portable y extensible, lo elijas gestionar tú mismo o a través de un servicio gestionado.

Nuevas capacidades del motor: OWL Import y Dynamic Sampling
Dos mejoras más técnicas, pero con impacto directo en el día a día de cualquier equipo de plataforma:
– Importación de OWL: permite cargar directamente ontologías y taxonomías de clasificación existentes en formato OWL (Web Ontology Language), reutilizando activos de taxonomía estándar del sector o desarrollados internamente, en lugar de reconstruirlos desde cero.
– Dynamic Sampling por defecto: el Profiler deja de escanear el 100% de las filas de cada tabla por defecto y adopta un muestreo dinámico, lo que reduce de forma significativa el coste de las consultas y el tiempo de ejecución sobre tablas grandes. Si tus flujos de trabajo dependen de recuentos exactos de valores distintos (para clasificación, etiquetado o reglas personalizadas), conviene revisar la configuración del Profiler tras la actualización y añadir explícitamente la distribución de cardinalidad donde sea necesario.
El ecosistema: conectores, comunidad y Agent Skills
OpenMetadata 2.0 no vive solo de su núcleo: se apoya en un ecosistema de más de 200 conectores activos y en aportaciones comunitarias constantes, como el conector de Prefect (que aporta linaje interactivo completo de tareas, ejecuciones de DAG y dependencias de pipelines) o el conector de Omni.
Para acelerar ese crecimiento, la versión 2.0 introduce Agent Skills como la *Connector Building Skill*, un marco guiado por modelos de lenguaje que asiste de extremo a extremo a los desarrolladores comunitarios en la construcción de conectores bajo el estándar de OpenMetadata: desde el andamiaje de la estructura de carpetas y dependencias en Python, hasta la generación del esquema JSON, la creación de recursos gráficos, la validación, el formateo del código y la creación automatizada de Pull Requests listos para revisión.
Esto no es un detalle menor: significa que el ritmo de nuevos conectores y mejoras va a seguir acelerándose, porque parte del trabajo de construcción ya lo hace la propia IA sobre la que se apoya el proyecto.
Detrás de todo esto hay una comunidad muy activa: más de 14.000 miembros en Slack, cientos de colaboradores de código y un ritmo de lanzamientos mensual, con sesiones de soporte semanales (Office Hours) y meetups mensuales donde se presentan en directo las novedades de cada versión.
OpenMetadata o Collate: ¿cuál elegir?
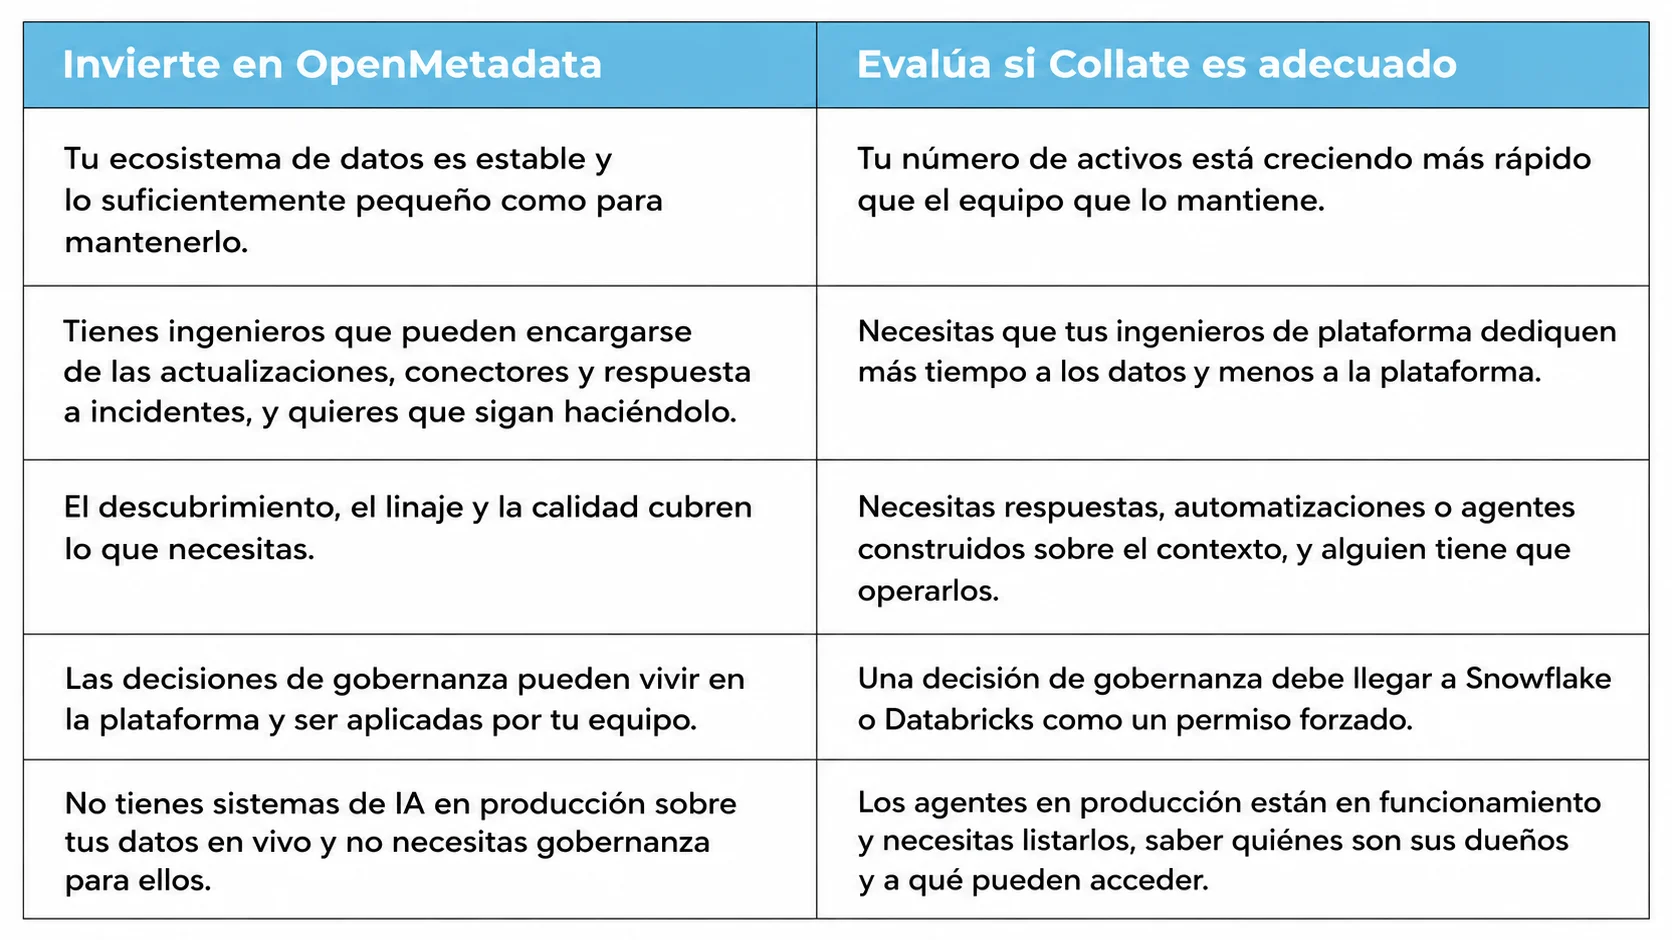
Una pregunta habitual cuando se plantea la actualización es si conviene quedarse en la versión open source o dar el salto a Collate, el servicio gestionado construido sobre OpenMetadata. No hay una respuesta única: depende del tamaño del equipo, la madurez de la plataforma de datos y el apetito por operar la infraestructura internamente.
Según el propio anuncio de la comunidad, compañías como OpenAI, Carrefour o Wix encuentran en la versión open source de OpenMetadata la capa de contexto que necesitan para su día a día. Otras, como Mercedes-Benz, Mango o S&P Global, prefieren acelerar sus iniciativas de datos e IA con las capacidades agénticas y el servicio gestionado de Collate. Ambos enfoques son enterprise-ready, escalables y extensibles; la decisión no implica renunciar a portabilidad ni a estándares abiertos, porque en ambos casos el contexto se mantiene open, portable y extensible.
Collate 2.0 añade sobre esta base un conjunto de capacidades pensadas para equipos empresariales:
– Collate AI Analytics: preguntas de negocio en lenguaje natural resueltas a través de métricas, glosario, relaciones, memories y políticas, con el SQL generado y el razonamiento trazable hasta la fuente vía lineage.
– Shared Chats: hilos compartidos entre personas y agentes de IA, con menciones, acceso basado en rol y auditoría de cada contribución.
– Governed Dashboards: promoción de un chart de chat a dashboard gobernado, con owner, control de acceso, estado y build history.
– AI Automations: instrucciones en lenguaje natural convertidas en procesos repetibles (documentación, clasificación, tiering, calidad de datos, PII discovery, glossary linking…), cada uno con owner, permisos y logs.
– AI Studio: builder de agentes con Workers, Personas y Plugins, y un planner en lenguaje natural; admite el servicio de IA propio de Collate o traer tu propio LLM (OpenAI, Anthropic, Bedrock, Vertex, on-premises).
– Data Access Requests: solicitudes de acceso con alcance y caducidad que se convierten en un grant real en Snowflake o Databricks, revocado automáticamente al expirar.
– AI Governance Studio (release preview): gobierna aplicaciones de IA, LLMs, servidores MCP y agentes en el mismo grafo que los datos, con AI Asset Registry y checks de cumplimiento frente al EU AI Act, NIST AI RMF e ISO/IEC 42001.
– Managed Runtime: SLA del 99,9%, certificación SOC 2 Type II y despliegue como SaaS, Hybrid Runner, BYOC u on-premises.
Por qué esto importa para tu negocio, no solo para tu equipo de datos
Es fácil leer todo lo anterior como funcionalidades técnicas de interés solo para el equipo de ingeniería de datos. Pero el trasfondo es otro: cada vez más decisiones de negocio van a pasar, directa o indirectamente, por un agente de IA que consulta tus datos. Si ese agente no tiene contexto de negocio fiable, gobernado y actualizado, el riesgo no es que «no funcione»: el riesgo es que dé una respuesta convincente pero incorrecta, y que alguien tome una decisión basándose en ella.
OpenMetadata 2.0 no resuelve esto por arte de magia, pero pone sobre la mesa la infraestructura necesaria para hacerlo bien: un contexto centralizado, una ontología de negocio explícita, memoria de decisiones ya validadas, control de acceso heredado de extremo a extremo y una forma estandarizada (vía MCP) de entregar todo eso a cualquier agente, propio o de terceros.
¿Cómo puede ayudarte Modus?
Actualizar de la rama 1.x a OpenMetadata 2.0 o adoptar la plataforma por primera vez no es solo cuestión de correr un script de migración. Implica revisar cómo están modelados tus dominios y productos de datos, decidir qué políticas y documentos merece la pena volcar en el nuevo Context Center, definir las personas y reglas de curación de contexto, y conectar todo esto de forma segura a los agentes de IA que tu organización ya está construyendo o planea construir.
En Modus ayudamos a empresas a dar este salto de principio a fin:
– Auditoría de tu instalación actual de OpenMetadata (o de tu catálogo de datos, si aún no usas ninguno) para diseñar un plan de migración a 2.0 sin sorpresas.
– Migración guiada a OpenMetadata 2.0, incluyendo la reconfiguración de conectores, la revisión del Profiler tras el cambio a Dynamic Sampling y la puesta a punto del nuevo motor de búsqueda semántica.
– Diseño del Context Center: qué políticas, runbooks y documentos de negocio incorporar, y cómo vincularlos a tus activos críticos.
– Configuración del «Persona-Based Context Curation» y del servidor MCP, para que tus agentes de IA trabajen con datos de confianza sin comprometer la seguridad ni disparar el consumo de tokens.
Si tu organización depende de OpenMetadata para gobernar sus datos o está evaluando dar el salto a una capa de contexto abierta para sus proyectos de IA hablemos. Contacta con nuestro equipo y te ayudamos a convertir esta actualización en una ventaja competitiva real, no solo en una tarea pendiente de mantenimiento.


